目录
一、深度学习概论
1.1 神经网络
激活函数ReLU(基本修正单元Rectified linear unit),一开始是零,后面沿直线上升。
一个神经网络中每一个单元都可能是ReLU或者其他非线性单元。
1.2 监督学习
(1)深度学习的应用领域
在监督学习中,先输入X,然后学习到一个函数,映射输出到Y。
目前深度学习在线上广告投放、图像处理、语音识别、机器翻译、无人驾驶等领域已经发挥了重要的作用。但每一项应用都需要我们合理选择x和y,才能解决特定问题。
(2)一些常用框架
价格预测,通用标准的神经网络框(Standard NN) 图像处理,卷积神经网络CNN(Convolutional NN) 序列处理,如音频,循环神经网络RNN(Recurrent NN) 语言处理,使用更复杂的RNNs 无人驾驶中使用图像和雷达,会使用更复杂的混合的神经网络结构
(3)结构化数据与非结构化数据
结构化数据,是数据的数据库,例如价格预测时会有标准的数据库,广告投放时会有用户信息,广告信息等数据库。
非结构化数据指语音、图像、视频、文本等,相比较结构化数据,更难以让计算机理解。
1.3 关于深度学习
深度学习近年强势发展的主要因素。
以前的算法,比如传统机器学习向量机等,随着数据量的增大,算法的表现基本没有提高。早期数据很少,随着数据的增多,算法有了一些提高,但后期人们进入数据化时代,每个人每天都在产生大量数据,数据量越来越大,但以前的算法却并没有得到更好的结果。
这时如果使用数据训练一个小型的神经网络,算法表现会比以前好很多,如果训练一个更复杂的大型神经网络,那么得到的结果会更好。虽然数据量增大会使训练时间增高,但如今大型神经网络已经帮著人类取得了很多很多成果。
另一方面,以前的SVM向量机的训练好坏更却决于认为手动设计,二现在神经网络更加通用。
其次是计算能力,CPU和GPU运算能力的提升也是深度学习发展的基础。
算法方面的创新也极大地促进了深度学习,许多算法的提出都是为了改善神经网络的性能,增加计算速度。
二、神经网络编程基础
2.1 符号定义
对于想要遍历数据集的情况,尽量不要使用for循环。
例如识别一张猫的图片是否是猫。
首先我们获取一张图片,其由3个矩阵(RGB)组成,我们可以将每一个矩阵所有像素值提取出来列成一个特征向量。这样输入的矩阵维度就是3xheightxwidth。
输入就是特征向量,输出就是标签0/1代表有猫还是没猫。
用数字符号表示为如下:
输入与输出:
数据集:
通常会将输入数据以列向量的形式构建为一个输入矩阵
输入矩阵,其行列数为。
同样输出数据也会构建为一个输出矩阵
输入矩阵,其行列数为。
2.2 二元分类问题——logistic回归方法
(1)二元分类问题
对于一个神经网络的问题,比如图像目标识别,输出的结果,即图片要么是目标,要么不是。
我们给定了图片输入特征向量,期望得到一个预测值,判断图片是不是我们想要的目标,预测的过程相当于求一个概率:
(2)logistic方法
由于二元分类问题,预测结果应为[0,1],因此线性方式一般不使用,因为线性表达,Y可以无穷大也。常用的方法是在线性的基础上再使用sigmoid函数。
其中是的系数向量,是常数,是一个拦截器,是sigmoid函数。利用就可以将直线输出转换为[0,1]输出。
(3)损失函数Loss
损失函数Loss是单个样本的预测值与实际值之差
为了训练和,我们需要定义一个损失函数,用来描述与的接近程度。再logistic方法中我们使用下面的函数作为损失函数Loss。
对于损失函数,我们希望它越小越好。
当时,,可以看出来越大(),Loss越小。
同理时,,可以看出来越小(),Loss越小。
(再其他方法中可能会用方差作为Loss函数,这里不用是因为方差得到的结果是凹凸的,也就是会有多个局部最优解,不便于后续梯度下降求全局最优解,而上面的Loss函数则解决了这个问题)
(4)成本函数
成本函数是全体样本的预测值与实际值之差
2.3 梯度下降法
成本函数衡量了训练集的预测效果,我们想要的时找到合适的 使得成本函数 尽可能小,这就用到了梯度下降法。
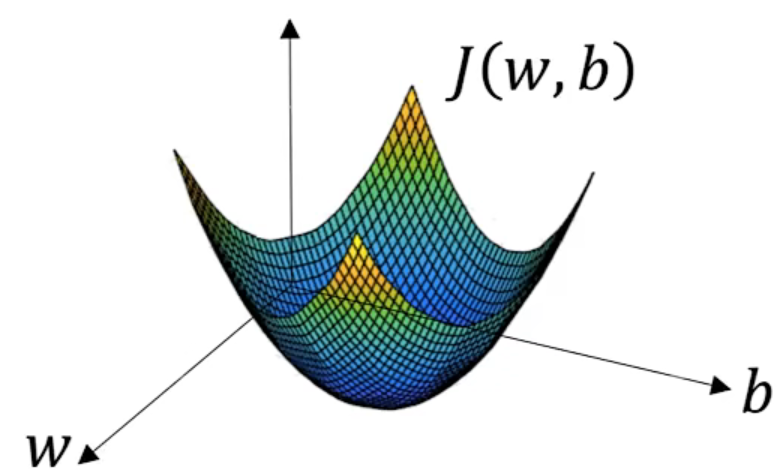
由于成本函数 是凸函数,因此函数形状是如下图这样的,这也是我们为什么定义损失函数那样形式的原因。
我们要做的是初始化一个 的值,然后让其向梯度下降的方向走,直到找到梯度最低的点。
以 为例,我们将重复以下过程:,来更新 ,其中 是学习率参数,可以看出如果斜率越大,那么每次迭代w变化也越大。
实际中我们会使用下面的方程进行梯度下降求解
2.4 计算图
计算图是从左到右的计算,来计算成本函数 。
对于一个流程图,可以很容易的看出 的导数。反向传播,就是从最终输出反推 对各个中间变量以及输入的导数。
在程序里,通常约定编程时使用dvar代表最终输出变量对于变量var的导数
代码大致过程如下:
# 初始化
J = 0
dw1 = 0
dw2 = 0
db = 0
# 遍历数据集
for i = 1 to m
	# 计算损失函数与成本函数
	zi = w1 * x1 + w2 * x2 +b
	ai = 1/(1+exp(-zi))
	J += -[yi * log(ai) + (1 - yi) * log(1-ai)]
	# 求导
	dzi = ai -yi
	dw1 += x1 * dzi
	dw2 += x2 * dzi
	db += dzi
# 解出各参数优化后的值
J/=m
dw1/=m
dw2/=m
db/=m
# 梯度下降
w1=w1-a*dw1
w2=w2-a*dw2
b=b-a*db
2.5 向量化
(1)什么是向量化
由于输入数据和系数都是列向量,对于这两个向量相乘,如果使用非向量化的方法即for循环实现,运算速度非常慢,而如果使用向量化的方法,例如在numpy中使用z=np.dot(w,x)实现两个向量的点乘,运算速度会快的多。
import time

# 向量化
a = np.random.rand(1000000)
b = np.random.rand(1000000)
tic = time.time()
c = np.dot(a,b)
toc = time.time()
print("Vectorized:" + str(1000*(toc-tic))+"ms")
# 非向量化
a = np.random.rand(1000000)
b = np.random.rand(1000000)
tic = time.time()
for i in range(1000000):
	c += a[i]*b[i]
toc = time.time()
print("For Loop:" + str(1000*(toc-tic))+"ms")

# 结果向量化的方法用时1.5ms,for循环方法500ms
对于这个小算法区分还不明显,但如果你训练一个神经网络使用非向量化方法需要300小时,向量化方法只需要1个小时,那样差距就非常明显了。
(2)前向传播的向量化
前向传播的目的是计算和
可以通过以下方式实现向量化: 其中是输入矩阵,每列是每一个样本的所有特征,共有m列即共m个样本;是参数组成的行向量。
以python程序表示上述过程:
Z=np.dot(w.T, X) + b(3)梯度计算的向量化
梯度计算就是计算、和
可以通过以下方式实现向量化:
将, 和向量化:
则,
以python表达
Z=np.dot(w.T,x)+b
A=sigmod(Z)
dZ=A-Y
db=np.sum(dZ)/m
dw=np.dot(X,dZ^T)/m
w=w-a1*dw
b=b-a2*db
(4)总结 为了加快代码计算速度,我们使用了向量化的手段,即尽量使用numpy计算数据集而不是用for循环。
输入矩阵 ,个样本,每个样本个特征
,其中
参数矩阵 ,每个特征对应一个参数
参数 ,每个特征对应一个参数
线性值 ,相当于简化版 ,每个样本都会计算得到一个计算值
预测值 ,每个样本一个预测值
损失函数 ,每个样本的预测值与标定值距离
成本函数 ,所有损失函数平均值
导数
导数
导数
2.6 关于numpy与常用函数
最好不要使用秩为1的数组a=np.random.randn(5),而要使用或的矩阵。也就是直接定义成行列向量a=np.random.randn(5,1),或者使用reshape改变形状。
如果不确定某个向量的维度,可以使用assert声明来判断。
assert(a.shape==(5,1))(1)sigmod函数
def sigmoid(x):
    """
    参数:
    x -- 任意形状的numpy数组

    返回值:
    s -- sigmoid(x)
    """

    s=1/(1+np.exp(-x))

    return s
(2)梯度计算
def sigmoid_derivative(x):
    """
    参数:
    x -- numpy数组

    返回值:
    ds -- 计算的梯度值
    """

    s = 1/(1+np.exp(-x))
    ds = s*(1-s)

    return ds
**(3)输入图片变形为[width x height x 3, 1]
def image2vector(image):
    """
    参数:
    image -- 特定形状的numpy数组 shape(length, height, depth)

    返回值:
    v -- 向量形式的数组 shape(length*height*depth, 1)
    """

    v = image.reshape(image.shape[0]*image.shape[1]*image.shape[2],1)

    return v
(4)归一化处理
def normalizeRows(x):
    """
    参数:
    x -- 一个二维numpy数组 shape(n, m)

    返回值:
    x -- 按行归一化后的numpy矩阵
    """

    # 计算x数组的模
    x_norm = np.linalg.norm(x,ord=2,axis=1,keepdims=True)
    # 用x除以它的模
    x=x/x_norm

return x| 参数 | 说明 | 计算方法 |
|---|---|---|
| ord=默认 | 二范数: | |
| ord=2 | 二范数: | 同上 |
| ord=1 | 一范数: | |
| ord=np.inf | 无穷范数: | $MAX\lvert x_i\rvert$ |
| axis=1 | 按行向量处理 | |
| axis=0 | 按列向量处理 | |
| axis=None | 矩阵范数 |
(5)softmax函数
softmax函数是一个规范化函数,用于算法需要分类两个或多个类的情况。
x_{11} & x_{12} & x_{13} & \dots & x_{1n} \\ x_{21} & x_{22} & x_{23} & \dots & x_{2n} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ x_{m1} & x_{m2} & x_{m3} & \dots & x_{mn} \end{bmatrix} = \begin{bmatrix} \frac{e^{x_{11}}}{\sum_{j}e^{x_{1j}}} & \frac{e^{x_{12}}}{\sum_{j}e^{x_{1j}}} & \frac{e^{x_{13}}}{\sum_{j}e^{x_{1j}}} & \dots & \frac{e^{x_{1n}}}{\sum_{j}e^{x_{1j}}} \\ \frac{e^{x_{21}}}{\sum_{j}e^{x_{2j}}} & \frac{e^{x_{22}}}{\sum_{j}e^{x_{2j}}} & \frac{e^{x_{23}}}{\sum_{j}e^{x_{2j}}} & \dots & \frac{e^{x_{2n}}}{\sum_{j}e^{x_{2j}}} \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ \frac{e^{x_{m1}}}{\sum_{j}e^{x_{mj}}} & \frac{e^{x_{m2}}}{\sum_{j}e^{x_{mj}}} & \frac{e^{x_{m3}}}{\sum_{j}e^{x_{mj}}} & \dots & \frac{e^{x_{mn}}}{\sum_{j}e^{x_{mj}}} \end{bmatrix} = \begin{pmatrix} softmax\text{(first row of x)} \\ softmax\text{(second row of x)} \\ ... \\ softmax\text{(last row of x)} \\ \end{pmatrix} $$ ```python def softmax(x): """ 参数: x -- 一个二维numpy数组 shape(n, m) 返回值: x -- softmax后的numpy矩阵 """ # 计算exp(x) x_exp = np.exp(x) # 创建向量x_sum对x_exp的每一行求和 x_sum = np.sum(x_exp, axis = 1, keepdims = True) # 两者相除计算softmax s = x_exp / x_sum return s ``` **(6)Loss函数** L1 Loss函数,用于评价模型的表现,loss越大,说明预测值和真实值的偏差预约。 $$\begin{align*} & L_1(\hat{y}, y) = \sum_{i=0}^m|y^{(i)} - \hat{y}^{(i)}| \end{align*}\tag{6}$$ ```python def L1(yhat, y): """ 参数: yhat -- 长度m的向量(预测值) y -- 长度m的向量(真实值) 返回值: loss -- 上面定义的L1 Loss值 """ loss = np.sum(np.abs(y-yhat)) return loss ``` L2 Loss函数。 $$\begin{align*} & L_2(\hat{y},y) = \sum_{i=0}^m(y^{(i)} - \hat{y}^{(i)})^2 \end{align*}\tag{7}$$ ```python def L2(yhat, y): """ 参数: yhat -- 长度m的向量(预测值) y -- 长度m的向量(真实值) 返回值: loss -- 上面定义的L2 Loss值 """ loss = np.sum(np.dot(y-yhat,y-yhat)) return loss ``` ## 2.7 总结 **(1)数学过程** 二分神经网络目的是给定一个输入 $x$(可以是图片等),输出预测值 $\hat y$,并尽可能让预测值 $\hat y$ 接近实际值 $y$,即: $\hat{y}=P(y=1|x)$ 而输出预测值 $\hat y$ 与输入 $x$ 之间的函数关系可以表示为(在线性表达的基础上加上sigmod函数,保证输出位于[0,1]区间) $$\hat y=\sigma{(wx+b)}$$ 其中定义 $z=wx+b$,$\sigma(z)=\frac{1}{1+e^{-z}}$ 这其中我们需要做的就是找到最合适的 $w$ 和 $b$ ,使输出 $\hat y$ 尽可能接近 $y$。 因此为了衡量 $\hat y$ 与 $y$ 的接近程度,我们定义了一个损失函数Loss,只要让损失函数足够小,就能保证 $\hat y$ 与 $y$ 足够接近。 $$L(\hat y,y)=-y\log{\hat y}-(1-y)\log{(1-\hat y)}$$ 当 $y=1$ 时, $L(\hat y,y)=-\log{\hat y}$,我们想要 $L(\hat y,y)$ 足够小,就要让 $\hat y$ 足够大即 $\hat y\rightarrow y=1$(由于时二分问题,$y\in [0,1]$) 当 $y=0$ 时, $L(\hat y,y)=-\log{(1-\hat y)}$,我们想要 $L(\hat y,y)$ 足够小,就要让 $\hat y$ 足够小即 $\hat y\rightarrow y=0$。 以上就说明了为什么这个损失函数能够描述 $\hat y$ 与 $y$ 的接近程度。 而上面只是一个样本 $x$ 的损失函数,而对于一个问题一般会输入大量的样本,假设有 $m$ 个,对于每一个样本都需要按照上述方法计算一个损失函数,而所有损失函数的平均值就是我们的输入的整体成本函数。 $$J(w,b)=\frac{1}{m}\sum^{n_x}_{i=1}L(\hat y^{(i)},y^{(i)})$$ 因此训练的目的就变成了找到让 $J(w,b)$ 的极小值时的 $w$ 和 $b$。 因此每次训练迭代,都需要对成本函数求导 $\frac{\partial J}{\partial w}$ 和 $\frac{\partial J}{\partial b}$,然后根据求导结果更新 $w=w-\alpha \frac{\partial J}{\partial w}$ 和 $b=b-\frac{\partial J}{\partial w}$,直到找到 $J_{min}$ 对应的 $w$ 和 $b$,此时训练就完成了。 **(2)代码过程** ```python import numpy as np import matplotlib.pyplot as plt import h5py # 常用数据集交互工具,数据集被保存为H5文件 import scipy # 用于图片测试 from PIL import Image from scipy import ndimage # 数据集加载函数 def load_dataset(): train_dataset = h5py.File('datasets/train_catvnoncat.h5', "r") train_set_x_orig = np.array(train_dataset["train_set_x"][:]) # your train set features train_set_y_orig = np.array(train_dataset["train_set_y"][:]) # your train set labels test_dataset = h5py.File('datasets/test_catvnoncat.h5', "r") test_set_x_orig = np.array(test_dataset["test_set_x"][:]) # your test set features test_set_y_orig = np.array(test_dataset["test_set_y"][:]) # your test set labels classes = np.array(test_dataset["list_classes"][:]) # the list of classes train_set_y_orig = train_set_y_orig.reshape((1, train_set_y_orig.shape[0])) test_set_y_orig = test_set_y_orig.reshape((1, test_set_y_orig.shape[0])) return train_set_x_orig, train_set_y_orig, test_set_x_orig, test_set_y_orig, classes # sigmoid函数 def sigmoid(x): """ 参数: x -- numpy数组 返回值: s -- 计算的sigmoid值,sigmoid(z)=1/(1+e^(-z)) """ s = 1/(1+np.exp(-x)) return s # 初始化参数,为w, b创建0向量 def initialize_with_zeros(dim): """ 参数: dim -- w向量的长度 返回值: w -- 初始化的向量, w.shape() -> (dim, 1) b -- 初始化的标量, 偏置值b """ w = np.zeros([dim,1]) b = 0 assert(w.shape == (dim, 1)) assert(isinstance(b, float) or isinstance(b, int)) return w, b # 前向和后向传播函数,计算成本函数和梯度值 def propagate(w, b, X, Y): """ 参数: w -- weights权重, numpy数组 w.shape -> (num_px * num_px * 3, 1) b -- bias偏置, 标量 X -- 数据 X.shape -> (num_px * num_px * 3, number of examples) Y -- 标签向量 (0非猫; 1猫) Y.shape -> (1, number of examples) 返回值: cost -- 成本函数(逻辑回归的负对数) dw -- 损失函数对w的梯度,与w维度相同 db -- 损失函数对b的梯度,与b维度相同 """ m = X.shape[1] # 前向传播(从数据X获得成本函数cost) A = sigmoid(np.dot(w.T,X) + b) cost = - 1/m * np.sum(Y*np.log(A) + (1-Y)*np.log(1-A)) # 后向传播(计算梯度) dw = 1/m * np.dot(X, (A-Y).T) db = 1/m * np.sum(A-Y) assert(dw.shape == w.shape) assert(db.dtype == float) cost = np.squeeze(cost) assert(cost.shape == ()) grads = {"dw": dw, "db": db} return grads, cost # 优化函数,通过梯度下降算法优化w和b def optimize(w, b, X, Y, num_iterations, learning_rate, print_cost = False): """ 参数: w -- weights权重, numpy数组 w.shape -> (num_px * num_px * 3, 1) b -- bias偏置, 标量 X -- 数据 X.shape -> (num_px * num_px * 3, number of examples) Y -- 标签向量 (0非猫; 1猫) Y.shape -> (1, number of examples) num_iterations -- 优化循环的迭代次数 learning_rate -- 学习率 print_cost -- True则每100次打印1次成本函数 返回值: params -- 包括 权重w和偏置b 的字典 grads -- 包括 成本函数对w和b梯度 的字典 costs -- 优化过程中所有的成本函数列表 """ costs = [] for i in range(num_iterations): # 成本函数和梯度计算 grads, cost = propagate(w, b, X, Y) # 从grads字典中获取梯度dw和db dw = grads["dw"] db = grads["db"] # 更新w和b w = w - learning_rate * dw b = b - learning_rate * db # 记录成本函数 if i % 100 == 0: costs.append(cost) # 每100个训练样本打印1次成本函数 if print_cost and i % 100 == 0: print ("Cost after iteration %i: %f" %(i, cost)) params = {"w": w, "b": b} grads = {"dw": dw, "db": db} return params, grads, costs # 预测函数,利用学习到的逻辑回归w和b预测标签 def predict(w, b, X): ''' 参数: w -- weights权重, numpy数组 w.shape -> (num_px * num_px * 3, 1) b -- bias偏置, 标量 X -- 数据 X.shape -> (num_px * num_px * 3, number of examples) 返回值: Y_prediction -- numpy向量包含对所有X样本的预测值 (0/1) ''' m = X.shape[1] Y_prediction = np.zeros((1,m)) w = w.reshape(X.shape[0], 1) # 计算预测值A,预测图片中的是否是猫 A = sigmoid(np.dot(w.T, X) + b) for i in range(A.shape[1]): # 转换概率 A[0,i] 到真实的概率 p[0,i] if A[0,i] < 0.5: Y_prediction[0,i] = 0 else: Y_prediction[0,i] = 1 assert(Y_prediction.shape == (1, m)) return Y_prediction # 综合以上函数,构建逻辑回归模型 def model(X_train, Y_train, X_test, Y_test, num_iterations = 2000, learning_rate = 0.5, print_cost = False): """ 参数: X_train -- 训练数据 (num_px * num_px * 3, m_train) Y_train -- 训练数据标签 (1, m_train) X_test -- 测试数据 (num_px * num_px * 3, m_test) Y_test -- 测试数据标签 (1, m_test) num_iterations -- 迭代次数 learning_rate -- 学习率 print_cost -- 是否打印成本函数 返回值: d -- 包含模型信息的字典 """ # 初始化参数 w, b = initialize_with_zeros(X_train.shape[0]) # 梯度下降 params, grads, costs = optimize(w, b, X_train, Y_train, num_iterations, learning_rate, print_cost) # 从params中获得w和b w, b = params["w"], params["b"] # 预测训练和测试样本 Y_prediction_train = predict(w, b, X_train); Y_prediction_test = predict(w, b, X_test) # 打印训练和测试的准确率 print("train accuracy: {} %".format(100 - np.mean(np.abs(Y_prediction_train - Y_train)) * 100)) print("test accuracy: {} %".format(100 - np.mean(np.abs(Y_prediction_test - Y_test)) * 100)) d = {"costs": costs, "Y_prediction_test": Y_prediction_test, "Y_prediction_train" : Y_prediction_train, "w" : w, "b" : b, "learning_rate" : learning_rate, "num_iterations": num_iterations} return d # 加载数据集 # train_set_x_orig是训练图片数据,train_set_y是训练标签数据 # 每个图像都是正方形(num_px, num_px, 3) train_set_x_orig, train_set_y, test_set_x_orig, test_set_y, classes = load_dataset() # 获取数据集基本参数 m_train = train_set_x_orig.shape[0] # 训练数据数量 m_test = test_set_x_orig.shape[0] # 测试数据数量 num_px = train_set_x_orig.shape[1] # 图片长宽 # 展开训练数据集为一维 train_set_x_flatten = train_set_x_orig.reshape(train_set_x_orig.shape[0],-1).T test_set_x_flatten = test_set_x_orig.reshape(test_set_x_orig.shape[0],-1).T # 数据集标准化处理(将所有像素值[0, 255]映射到[0, 1]) train_set_x = train_set_x_flatten/255 test_set_x = test_set_x_flatten/255 # 运行model进行训练 d = model(train_set_x, train_set_y, test_set_x, test_set_y, num_iterations = 20000, learning_rate = 0.005, print_cost = True) # 查看某张图片的预测结果 index = 1 plt.imshow(test_set_x[:,index].reshape((num_px, num_px, 3))) print ("y = " + str(test_set_y[0,index]) + ", you predicted that it is a \"" + classes[int(d["Y_prediction_test"][0,index])].decode("utf-8") + "\" picture.") # 画出学习曲线 costs = np.squeeze(d['costs']) plt.plot(costs) plt.ylabel('cost') plt.xlabel('iterations (per hundreds)') plt.title("Learning rate =" + str(d["learning_rate"])) plt.show() ``` # 三、神经网络 ## 3.1 神经网络的表示 一般的神经网络包括:输入层、隐藏层、输出层、输出值。 > 隐藏层:在训练集中,这些节点的数值我们不知道,我们能看到输入值、输出值,但是中间值我们在训练是看不到的,所以叫隐藏层。  上图就是标准的二层神经网络(输入层不算是标准的层),或者称为单隐层神经网络。 上面的网络中,输入层也可以用$a^{[0]}$表示,$a^{[0]}=X$,中间层可以用$a^{[1]}$表示,$a^{[1]}=[a^{[1]}_1 a^{[1]}_2 \cdots a^{[1]}_n]$,输出层可以用$a^{[2]}$表示。我们用方括号表示神经网络的层数。其中隐藏层和输出层有着各自的参数,分别记作$w^{[1]}, b^{[1]}$和$w{[2]}, b{[2]}$。 ## 3.2 神经网络的计算 神经网络的计算过程,就是上一节中的回归计算的多次叠加。下图为上一节所说的逻辑回归的流程。 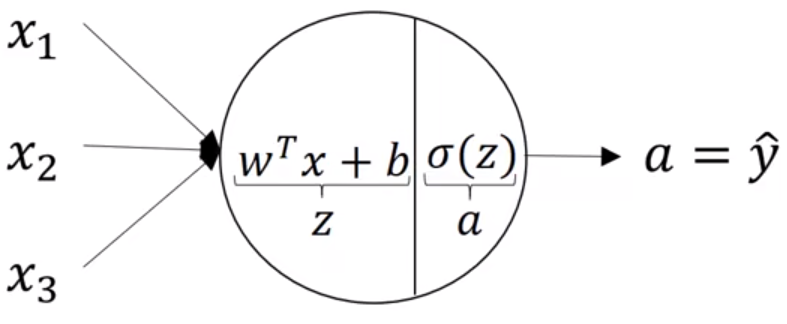 对应于二层神经网络中是如下图的部分(隐藏层与输入层之间),每一个隐层单元的计算过程都是同样的。 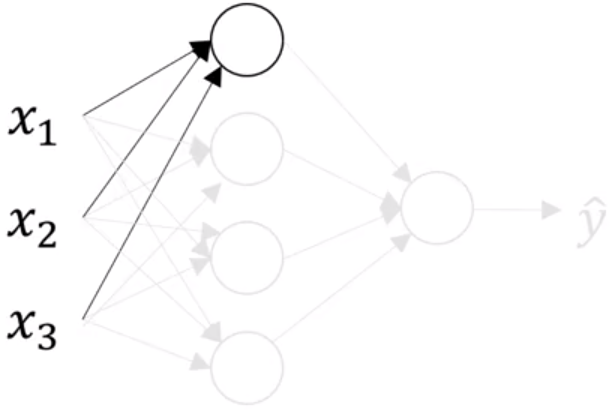 输出层与隐藏层之间的计算,也和隐藏层与输入层类似。只不过将隐藏层计算的$a^{[1]}$看作输入来进行回归运算。 用数学公式表示二层神经网络的计算过程: $$z^{[1]}=W^{[1]}x+b^{[1]}$$ $$a^{[1]}=\sigma (z^{[1]})$$ $$z^{[2]}=W^{[2]}a^{[1]}+b^{[2]}$$ $$a^{[2]}=\sigma (z^{[2]})$$ ## 3.3 激活函数 **(1)$\sigma$函数** 前面我们提到激活函数,都是使用的$\sigma$函数[0, 1],但实际中几乎不使用该函数。 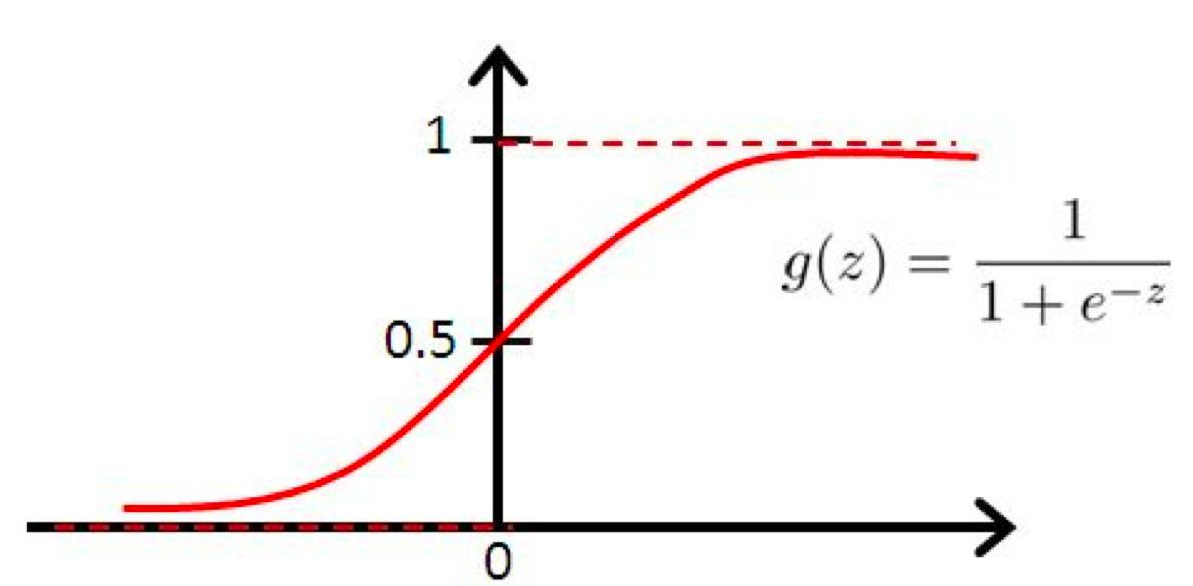 **(2)tanh函数** 更一般的情况下,我们会使用其他非线性函数例如$tanh = \frac{e^z-e^{-z}}{e^z+e^{-z}}$函数[-1, 1]。事实证明,对于隐藏层的激活函数,如果使用tanh效果几乎总比$\sigma$好。对于输出层,由于$\hat y \in [0, 1]$,因此使用$\sigma$函数效果更好。 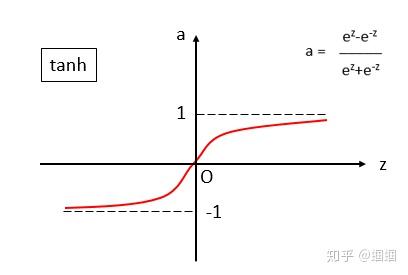 **(3)ReLU函数** 但是无论是$\sigma$还是tanh,我们都可以看出在z非常大或非常小时,激活函数的斜率都很小,这会严重影响梯度下降找到最优解的速度。因此人们提出了线性修正单元ReLU。 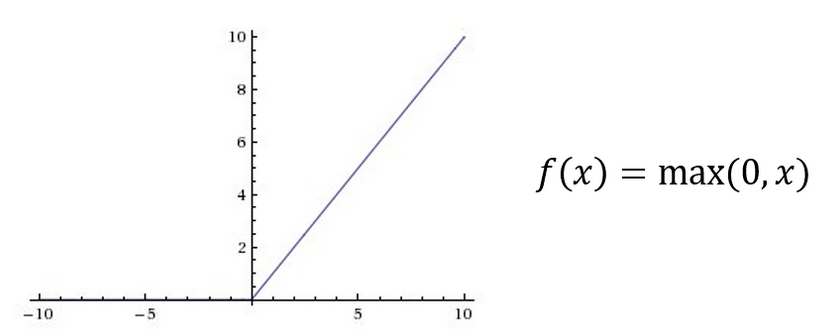 还有一种带泄露的线性修正单元 Leaky ReLU,在z<0时a不为0。 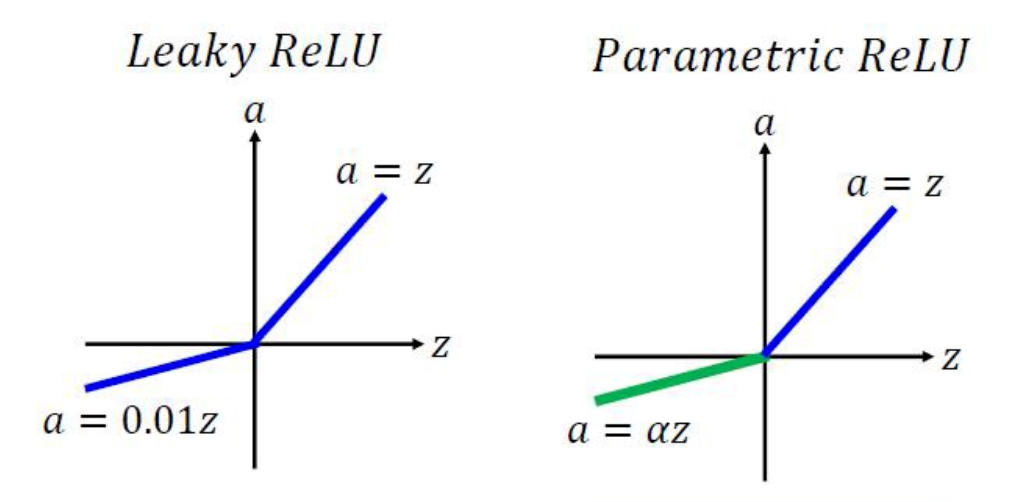 **(4)为什么需要非线性激活函数** 如果不使用机器学习,那么之前所说的二层神经网络的前向计算过程: $$z^{[1]}=W^{[1]}x+b^{[1]}$$ $$a^{[1]}=\sigma (z^{[1]})$$ $$z^{[2]}=W^{[2]}a^{[1]}+b^{[2]}$$ $$a^{[2]}=\sigma (z^{[2]})$$ 令$a^{[1]}=z^{[1]}$,那么计算过程就可以写成下面的形式: $$z^{[2]}=W^{[2]}z^{[1]}+b^{[2]}=W^{[2]}(W^{[1]}x+b^{[1]})+b^{[2]}=W'x+b'$$ 化简出来$z^{[2]}$与x之间可以线性表示,那么也就是说无论网络有多少层,都可以将输出和输入用一个线性函数表示,那么神经网络的作用就没法体现了。因此激活函数是十分必要的。 从另一个角度来说,神经网络模拟的就是神经元的信号传递过程,ReLU等激活函数,模拟的就是神经元的放电阈值,当电刺激达到一定阈值才会向下一神经元发送信号,如果激活函数达到阈值才会输出,否则就是0,也是为了去掉某些不重要的样本特征,防止出现过拟合等现象。 **(5)激活函数的导数** 如果是sigmod函数,即$g(z)=\frac{1}{1+e^{-z}}$,则容易计算得到$\frac{d}{dz}g(z)=\frac{1}{1+e^{-z}}] (1-\frac{1}{1+e^{-z}})=g(z)(1-g(z))$。 - z->+∞时,g(z)->1,g'(z)->0; - z->-∞时,g(z)->0,g'(z)->0 - z=0是,g(z)=0.5,g'(z)=0.25 如果是tanh函数,即$g(z)=\frac{e^z-e^{-z}}{e^z+e^{-z}}$,则容易计算得到$\frac{d}{dz}g(z)=1-(tanh(z))^2$。 - z->+∞时,g(z)->1,g'(z)->0; - z->-∞时,g(z)->-1,g'(z)->0 - z=0是,g(z)=0,g'(z)=1 如果是ReLU函数,即$g(z)=max(0,z)$,则容易计算得到 $g'(z)=0, if z<0$ $g'(z)=1, if z>=0$ (其中z=0时可以在程序中设置导数为1,避免不可导问题) ## 3.4 神经网络的梯度下降 对于一个神经网络,我们有以下参数:$w^{[1]}, b^{[1]}, w^{[2]}, b^{[2]}$ 我们计算的损失函数: $J(w^{[1]}, b^{[1]}, w^{[2]}, b^{[2]})=\frac{1}{m} \sum^n_{i=1}l(\hat y, y)$ 梯度下降过程重复以下步骤: 1. 计算预测值$\hat y$ 2. 计算导数:$d(w^{[1]})=\frac{\partial J}{\partial w^{[1]}}$,$d(b^{[1]})=\frac{\partial J}{\partial b^{[1]}}$ 3. 更新参数:$w^{[1]}=w^{[1]}-\alpha \frac{\partial J}{\partial w^{[1]}}$,$b^{[1]}=b^{[1]}-\alpha \frac{\partial J}{\partial b^{[1]}}$ 向量化之后反向传播的计算方法如下: $$dZ^{[2]}=A^{[2]}-Y$$ $$dW^{[2]}=\frac{1}{m}dZ^{[2]}A^{[1]T}$$ $$db^{[2]}=dZ^{[2]}$$ $$dZ^{[1]}=W^{[2]T}dZ^{[2]}*g^{[1]'}(Z^{[1]})$$ $$dW^{[1]}=\frac{1}{m}dZ^{[1]}X^T$$ $$db^{[1]}=dZ^{[1]}$$ ## 3.5 参数初始化 对于神经网络的各层权重参数,我们都需要进行初始化,但是如果只是初始化为0,那么神经网络将完全无效,因此我们需要进行随机初始化。 可以令 W[1]=np.random.randn((2,2))\*0.01 b[1]=np.zero((2,1)) W[1]=np.random.randn((1,2))\*0.01 b[1]=0 乘0.01是因为我们比较喜欢让权重尽可能小,这样z也将会比较小,更容易落在激活函数斜率大的区域,让神经网络回归的更快。 ## 3.6 代码实现 **(1)安装包** 在实现神经网络过程中需要导入一些必要的包 - numpy:基础的科学计算包 - sklearn:提供了数据挖掘和数据分析的简单有效的工具 - matplotlib:画图工具 **(2)神经网络** 建立神经网络的方法 1. 定义神经网络结构(输入单元数,隐藏单元数等) 2. 初始化模型的参数 3. 循环: - 实现前向传播 - 计算损失函数 - 后向传播获得梯度 - 梯度下降更新参数 1. 定义神经网络结构 ```python # GRADED FUNCTION: layer_sizes def layer_sizes(X, Y): """ 参数: X -- 输入数据集,shape(input size, number of examples) Y -- 标签,shape(output size, number of examples) 返回值: n_x -- 输入层的大小 n_h -- 隐藏层的大小 n_y -- 输出层的大小 """ n_x = X.shape[0] n_h = 4 n_y = Y.shape[0] return (n_x, n_h, n_y) ``` 2. 初始化模型参数 ```python def initialize_parameters(n_x, n_h, n_y): """ 参数: n_x -- 输入层的大小 n_h -- 隐藏层的大小 n_y -- 输出层的大小 返回值: params -- python字典包含以下参数: W1 -- 权重矩阵,shape (n_h, n_x) b1 -- 偏置向量,shape (n_h, 1) W2 -- 权重矩阵,shape (n_y, n_h) b2 -- 偏置向量,shape (n_y, 1) """ np.random.seed(2) W1 = np.random.randn(n_h, n_x) b1 = np.zeros((n_h, 1)) W2 = np.random.randn(n_y, n_h) b2 = np.zeros((n_y, 1)) assert (W1.shape == (n_h, n_x)) assert (b1.shape == (n_h, 1)) assert (W2.shape == (n_y, n_h)) assert (b2.shape == (n_y, 1)) parameters = {"W1": W1, "b1": b1, "W2": W2, "b2": b2} return parameters ``` 3. 前向传播计算 ```python def forward_propagation(X, parameters): """ 参数: X -- 输入数据,size (n_x, m) parameters -- 包含所有参数的字典 (上面初始化函数的输出) 返回值: A2 -- 第二次激活后的输出 cache -- 包含 "Z1", "A1", "Z2", "A2" 的字典 """ # 从字典 "parameters" 中获取各参数 W1 = parameters["W1"] b1 = parameters["b1"] W2 = parameters["W2"] b2 = parameters["b2"] # 前向传播计算A2 Z1 = np.dot(W1, X) + b1 A1 = np.tanh(Z1) Z2 = np.dot(W2, A1) + b2 A2 = np.tanh(Z2) assert(A2.shape == (1, X.shape[1])) cache = {"Z1": Z1, "A1": A1, "Z2": Z2, "A2": A2} return A2, cache ``` 4. 计算损失函数 ```python def compute_cost(A2, Y, parameters): """ 参数: A2 -- 第二次激活函数的输出,shape (1, number of examples) Y -- 真值向量,shape (1, number of examples) parameters -- 包含所有参数的字典 返回值: cost -- 损失函数 """ m = Y.shape[1] # 样本的数量 # 计算损失函数 logprobs = np.multiply(np.log(A2), Y) + np.multiply((1 - Y), np.log(1 - A2)) cost = - np.sum(logprobs) / m cost = np.squeeze(cost) # 保证损失函数的维度是我们想要的,例如把[[6]]变成6 assert(isinstance(cost, float)) return cost ``` 5. 反向传播 ```python def backward_propagation(parameters, cache, X, Y): """ 参数: parameters -- 包含所有参数的字典 cache -- 包含 "Z1", "A1", "Z2", "A2" 的字典 X -- 输入数据,shape (2, number of examples) Y -- 真值向量,shape (1, number of examples) 返回值: grads -- 包含所有参数的梯度值的字典 """ m = X.shape[1] # 从字典 "parameters" 中获取 W1, W2 W1 = parameters["W1"] W2 = parameters["W2"] # 从字典 "cache" 中获取 A1, A2 A1 = cache["A1"] A2 = cache["A2"] # 反向传播: 计算 dW1, db1, dW2, db2. dZ2 = A2 - Y dW2 = 1/m * np.dot(dZ2, A2.T) db2 = 1/m * np.sum(dZ2, axis = 1, keepdims = True) dZ1 = np.multiply(np.dot(W2.T, dZ2), (1 - np.power(A1, 2))) dW1 = 1/m * np.dot(dZ1, X.T) db1 = 1/m * np.sum(dZ1, axis = 1, keepdims = True) grads = {"dW1": dW1, "db1": db1, "dW2": dW2, "db2": db2} return grads ``` 6. 更新参数 ```python def update_parameters(parameters, grads, learning_rate = 1.2): """ 参数: parameters -- 包含所有参数的字典 grads -- 包含所有梯度的字典 返回值: parameters -- 包含所有更新后的参数的字典 """ # 从字典 "parameters" 中获取 W1, W2, b1, b2 W1 = parameters["W1"] b1 = parameters["b1"] W2 = parameters["W2"] b2 = parameters["b2"] # 从字典 "grads" 中获取梯度值 dW1, dW2, db1, db2 dW1 = grads["dW1"] db1 = grads["db1"] dW2 = grads["dW2"] db2 = grads["db2"] # 更新每个参数 W1 = W1 - learning_rate * dW1 b1 = b1 - learning_rate * db1 W2 = W2 - learning_rate * dW2 b2 = b2 - learning_rate * db2 parameters = {"W1": W1, "b1": b1, "W2": W2, "b2": b2} return parameters ``` 7. 函数整合 ```python def nn_model(X, Y, n_h, num_iterations = 10000, print_cost=False): """ 参数: X -- 数据集,shape (2, number of examples) Y -- 标签,shape (1, number of examples) n_h -- 隐藏层的大小 num_iterations -- 梯度下降循环的迭代次数 print_cost -- True则每1000次迭代打印cost 返回值: parameters -- 模型学习到的参数,可以被用来预测 """ np.random.seed(3) n_x = layer_sizes(X, Y)[0] n_y = layer_sizes(X, Y)[2] # 初始化参数, 获取 W1, b1, W2, b2 # Inputs: "n_x, n_h, n_y". Outputs = "W1, b1, W2, b2, parameters". parameters = initialize_parameters(n_x, n_h, n_y) W1 = parameters["W1"] b1 = parameters["b1"] W2 = parameters["W2"] b2 = parameters["b2"] # 梯度下降循环 for i in range(0, num_iterations): # 前向计算 # Inputs: "X, parameters". Outputs: "A2, cache". A2, cache = forward_propagation(X, parameters) # 损失函数 # Inputs: "A2, Y, parameters". Outputs: "cost". cost = compute_cost(A2, Y, parameters) # 反向传播 # Inputs: "parameters, cache, X, Y". Outputs: "grads". grads = backward_propagation(parameters, cache, X, Y) # 梯度下降参数更新 # Inputs: "parameters, grads". Outputs: "parameters". parameters = update_parameters(parameters, grads) # 每1000次迭代打印cost if print_cost and i % 1000 == 0: print ("Cost after iteration %i: %f" %(i, cost)) return parameters ``` 8. 预测 ```python def predict(parameters, X): """ 参数: parameters -- 包含训练好的参数的字典 X -- 输入数据,size (n_x, m) 返回值: predictions -- 模型的预测结果向量 """ # 计算前向传播的概率,并按概率0.5为界限进行二分分类 A2, cache = forward_propagation(X, parameters) predictions = np.round(A2) return predictions ``` # 四、深层神经网络 ## 4.1 前向传播 **(1)数学计算** $$z^{[1]}=W^{[1]}x+b^{[1]}$$ $$a^{[1]}=g(z^{[1]})$$ $$z^{[2]}=W^{[2]}a^{[1]}+b^{[2]}$$ $$a^{[2]}=g(z^{[2]})$$ $$\cdots$$ $$z^{[l]}=W^{[l]}a^{[l-1]}+b^{[l]}$$ $$a^{[l]}=g(z^{[l]})$$ **(2)向量化** $$Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]}$$ $$A^{[l]}=g(Z^{[l]})$$ ## 4.2 核对矩阵维数 **(1)推导过程** 对于计算过程: $$Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]}$$ 由于$Z^{[l]}$的行数等于每一层神经元单元数$n^{l}$,列数等于样本数$m$,因此其中的$Z^{[l]}$的维数为$(n^{[l]}, m)$。 $A^{[l-1]}$是由$Z^{[l-1]}$经过激活函数计算而得,因此维数与$Z^{[l-1]}$相同为$(n^{[l-1]},1)$。 根据矩阵计算的规则,可以知道$W^{[l]}$的维数为$(n^{[l]}, n^{[l-1]})$,$b$的维数应该与$Z^{[l]}$相同$(n^{[l]}, m)$,但是由于python的广播规则,因此程序中$b$的维数通常是$(n^{[l]}, 1)$ **(2)维数总结** $$W^{[l]}:(n^{[l]}, n^{[l-1]})$$ $$b^{[l]}:(n^{[l]}, 1)$$ $$dW^{[l]}:(n^{[l]}, n^{[l-1]})$$ $$db^{[l]}:(n^{[l]}, 1)$$ ## 4.3 参数和超参数 深度学习中我们用到的参数有: - 权值:$W^{[l]}$ - 偏置:$b^{[b]}$ 超参数包括: - 学习率:$\alpha$ - 迭代次数 - 隐藏层层数:L - 隐藏层单元数:$n^{[l]}$ - 激活函数的选择 所有的超参数都可以一定程度上决定最终得到的参数W和b。我们可以通过设定不同的超参数通过观察成本函数变化来判断当前超参数是否是最合适的,通常情况下超参数需要不断尝试检验才能找到对于当前问题最好的一个值。 ## 4.4 关键步骤编程实现 **(1)初始化参数** ```python def initialize_parameters_deep(layer_dims): """ 参数: layer_dims -- 包含每一层维度的列表 返回值: parameters -- 包含 "W1", "b1", ..., "WL", "bL" 的字典 Wl -- 权值矩阵,shape (layer_dims[l], layer_dims[l-1]) bl -- 偏置向量,shape (layer_dims[l], 1) """ np.random.seed(3) parameters = {} L = len(layer_dims) # 神经网络的层数 for l in range(1, L): parameters["W" + str(l)] = np.random.randn(layer_dims[l], layer_dims[l - 1]) * 0.01 parameters["b" + str(l)] = np.zeros((layer_dims[l], 1)) assert(parameters['W' + str(l)].shape == (layer_dims[l], layer_dims[l-1])) assert(parameters['b' + str(l)].shape == (layer_dims[l], 1)) return parameters ``` **(2)前向传播线性激活模块** ```python def linear_activation_forward(A_prev, W, b, activation): """ 参数: A_prev -- 上一层激活后的结果 (或输入数据),shape(上一层单元数, 样本数) W -- 权值矩阵,shape (当前层单元数, 上一层单元数) b -- 偏置向量,shape (当前层单元数, 1) activation -- 本层使用的激活函数, 字符串格式: "sigmoid" or "relu" 返回值: A -- 激活函数后的输出 cache -- 包含 "linear_cache" and "activation_cache" 的字典,便于反向传播的计算 """ if activation == "sigmoid": # Inputs: "A_prev, W, b". Outputs: "A, activation_cache". ### START CODE HERE ### (≈ 2 lines of code) Z = np.dot(W, A_prev) + b A, activation_cache = sigmoid(Z) ### END CODE HERE ### elif activation == "relu": # Inputs: "A_prev, W, b". Outputs: "A, activation_cache". ### START CODE HERE ### (≈ 2 lines of code) Z = np.dot(W, A_prev) + b A, activation_cache = relu(Z) ### END CODE HERE ### assert (A.shape == (W.shape[0], A_prev.shape[1])) cache = (linear_cache, activation_cache) return A, cache ``` **(3)L层神经网络** ```python def L_model_forward(X, parameters): """ 参数: X -- 输入数据,shape (input size, number of examples) parameters -- 初始化参数,initialize_parameters_deep()的输出 返回值: AL -- 激活函数的输出 caches -- 包括 每层linear_relu_forward()的cache (一共L-1个, 索引从0到L-2) linear_sigmoid_forward()的cache (只有一个, 索引为L-1) """ caches = [] A = X L = len(parameters) // 2 # 神经网络的层数 # 实现 [LINEAR -> RELU]*(L-1). 添加 "cache" 到 "caches" 列表. for l in range(1, L): A_prev = A A, cache = linear_activation_forward(A_prev, parameters["W" + str(l)], parameters["b" + str(l)], "relu") caches.append(cache) # 实现 LINEAR -> SIGMOID. 添加 "cache" 到 "caches" 列表. AL, cache = linear_activation_forward(A, parameters["W" + str(L)], parameters["b" + str(L)], "sigmoid") caches.append(cache) assert(AL.shape == (1,X.shape[1])) return AL, caches ``` **(4)成本函数** ```python def compute_cost(AL, Y): """ 参数: AL -- 与输入的标签匹配的预测值向量, shape(1, number of examples) Y -- 真值标签向量 (例如: 不是猫为0,猫为1), shape (1, number of examples) 返回值: cost -- 成本函数 """ m = Y.shape[1] # 根据al, y计算成本函数 cost = -1 / m * np.sum(Y * np.log(AL) + (1-Y) * np.log(1-AL),axis=1,keepdims=True) cost = np.squeeze(cost) # 保证成本函数的向量是我们想要的,例如[[17]]变成17 assert(cost.shape == ()) return cost ``` **(5)线性部分反向传播** ```python def linear_backward(dZ, cache): """ 参数: dZ -- 第L层的线性输出的梯度 cache -- (A_prev, W, b)组成的元组,来自当前层的前向传播 返回值: dA_prev -- 上一层激活函数后的梯度 dW -- W的梯度 db -- b的梯度 """ A_prev, W, b = cache m = A_prev.shape[1] dW = 1/m * np.dot(dZ, A_prev.T) db = 1/m * np.sum(dZ,axis=1, keepdims=True) dA_prev = np.dot(W.T, dZ) assert (dA_prev.shape == A_prev.shape) assert (dW.shape == W.shape) assert (db.shape == b.shape) return dA_prev, dW, db ``` **(6)线性激活部分反向传播** ```python def linear_activation_backward(dA, cache, activation): """ 参数: dA -- 当前层激活后的梯度 cache -- (linear_cache, activation_cache)组成的元组,为了反向传播计算更快 activation -- 当前层所用的激活函数, 以字符串格式存储: "sigmoid" or "relu" 返回值: dA_prev -- 上一层激活后的梯度 dW -- W的梯度 db -- b的梯度 """ linear_cache, activation_cache = cache if activation == "relu": dZ = relu_backward(dA, activation_cache) dA_prev, dW, db = linear_backward(dZ, linear_cache) elif activation == "sigmoid": dZ = sigmoid_backward(dA, activation_cache) dA_prev, dW, db = linear_backward(dZ, linear_cache) return dA_prev, dW, db ``` **(7)线性模型反向传播** ```python def L_model_backward(AL, Y, caches): """ 参数: AL -- 概率向量, 前向传播的输出(L_model_forward()) Y -- 数据集真值向量 caches -- 列表包括 linear_activation_forward() 函数的cache (是caches[l], for l in range(L-1) i.e l = 0...L-2) linear_activation_forward() 函数的cache (是caches[L-1]) 返回值: grads -- 梯度的字典 grads["dA" + str(l)] = ... grads["dW" + str(l)] = ... grads["db" + str(l)] = ... """ grads = {} L = len(caches) # 层数 m = AL.shape[1] Y = Y.reshape(AL.shape) # 此行后,Y与YL相同 # 初始化反向传播 dAL = - (np.divide(Y, AL) - np.divide(1 - Y, 1 - AL)) # 第L层梯度 (SIGMOID -> LINEAR). 输入: "AL, Y, caches". 输出: "grads["dAL"], grads["dWL"], grads["dbL"] current_cache = caches[L-1] grads["dA" + str(L)], grads["dW" + str(L)], grads["db" + str(L)] = linear_activation_backward(dAL, current_cache, activation = "sigmoid") for l in reversed(range(L - 1)): # l层梯度 (RELU -> LINEAR) # 输入: "grads["dA" + str(l + 2)], caches". 输出: "grads["dA" + str(l + 1)] , grads["dW" + str(l + 1)] , grads["db" + str(l + 1)] current_cache = caches[l] dA_prev_temp, dW_temp, db_temp = linear_activation_backward(grads["dA" + str(l+2)], current_cache, activation = "relu") grads["dA" + str(l + 1)] = dA_prev_temp grads["dW" + str(l + 1)] = dW_temp grads["db" + str(l + 1)] = db_temp return grads ``` **(8)参数更新** ```python def update_parameters(parameters, grads, learning_rate): """ 参数: parameters -- 包含所有参数的python字典 grads -- 包含所有梯度的字典, L_model_backward 函数的输出 learning_rate -- 学习率 返回值: parameters -- 包含所有更新后参数的字典 parameters["W" + str(l)] = parameters["W" + str(l)] - learning_rate * grads["dW" + str(l + 1)] parameters["b" + str(l)] = parameters["b" + str(l)] - learning_rate * grads["db" + str(l + 1)] """ L = len(parameters) // 2 # 神经网络的层数 # 参数更新 for l in range(L): parameters["W" + str(l + 1)] -= learning_rate * grads["dW" + str(l + 1)] parameters["b" + str(l + 1)] -= learning_rate * grads["db" + str(l + 1)] return parameters ```
评论