一、Mini-batch梯度下降法
(1)为什么需要mini-batch
我们知道,在神经网络中常使用向量化的方法,来实现较快速的处理所有m个样本。
但是这样的方法,对于超大数量的样本来说,比如对于一个有100万样本的数据集,使用向量化的方法就代表将创建一个有100万列的超大矩阵,并且需要对整个数据集进行处理后才能进一步做梯度下降,这种方法称为batch梯度下降法。
为了解决这个问题,可以把训练集分割为小一些的子训练集,这些子集称为mini-batch,比如每次取出1000个样本进行训练,然后再取1000个样本训练。
(2)如何理解mini-batch
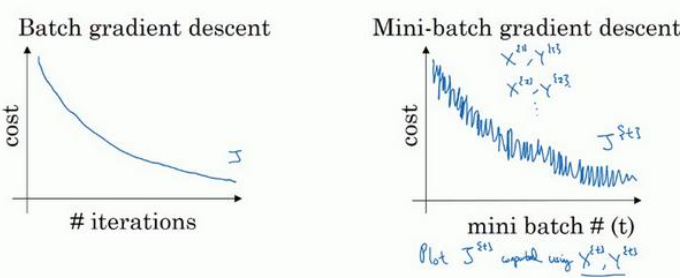
使用mini-batch梯度下降法时,每次迭代过程需要处理的是和,因此做出的成本函数图在取不同子集的过程中是不一样的,但由于权重和偏置是随着训练逐渐优化,因此整体的成本函数是震荡下降的。
(3)超参数:batch_size
在设置minibatch的过程中用到的一个超参数就是batch大小,如果训练集的大小是m的话:
- batch_size=m:mini-batch子集与整个训练集一样,其实就是batch梯度下降法,这种情况相对噪声低一些,幅度大一些,在此方法后可以继续寻找最小值。
- batch_size=1:叫做梯度下降法,每个样本都是独立的mini-batch,这种方法大部分情况下会像最小值靠近,有时会远离最小值,且有很多噪声,而且该方法永远不会手链,而是会一直在最小值附近波动。
实际工作中选择的mini-batch大小通常在两种极限情况之间,即1<batch_size<m。并且如果样本数量较小,就没必要划分子集了,直接使用batch梯度下降法即可,对于数目较大的数据,一般batch_size选择为64到512,根据电脑内存情况选取。
(4)编程实现
def random_mini_batches(X, Y, mini_batch_size = 64, seed = 0):
    """
    从(X, Y)创建随机的mini-batch

    参数:
    X -- 输入数据, shape (input size, number of examples)
    Y -- 真值向量, shape (1, number of examples)
    mini_batch_size -- mini-batches的大小,整形

    返回值:
    mini_batches -- 同步的列表 (mini_batch_X, mini_batch_Y)
    """

    np.random.seed(seed)
    m = X.shape[1]                  # 训练样本的数量
    mini_batches = []

    # Step 1: 打乱 (X, Y)
    permutation = list(np.random.permutation(m))
    shuffled_X = X[:, permutation]
    shuffled_Y = Y[:, permutation].reshape((1,m))

    # Step 2: 分区 (shuffled_X, shuffled_Y).
    num_complete_minibatches = math.floor(m/mini_batch_size) # 以mini_batch_size为大小的分区的数量
    for k in range(0, num_complete_minibatches):
        mini_batch_X = shuffled_X[:, k*mini_batch_size : (k+1)*mini_batch_size]
        mini_batch_Y = shuffled_Y[:, k*mini_batch_size : (k+1)*mini_batch_size]
        mini_batch = (mini_batch_X, mini_batch_Y)
        mini_batches.append(mini_batch)

    # 处理剩余的样本(少于mini_batch_size的样本)
    if m % mini_batch_size != 0:
        mini_batch_X = shuffled_X[:, num_complete_minibatches*mini_batch_size : m]
        mini_batch_Y = shuffled_Y[:, num_complete_minibatches*mini_batch_size : m]
        mini_batch = (mini_batch_X, mini_batch_Y)
        mini_batches.append(mini_batch)

    return mini_batches
二、动量梯度下降法
2.1 指数加权平均数
(1)什么是指数加权平均数
指数加权平均数,可以将震荡往复的噪声曲线拟合为一条平滑的曲线。
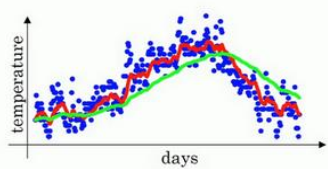
其数学表达式如下:
(2)如何理解指数加权平均数
以为例,我们可以写出下面的式子
我们将后两式代入第一式就可以得到:
可以看出来,这是一个对的加和和平均,对于来说,它由前99个数据决定,并且离100越近的数据,权重越大,离得越远的数据权重越小,权重是成指数衰减的函数。
(3)超参数:
在公式中,如果较大,说明在加权过程中,权重衰减更慢,因此可以看作对更多个数据的平均。如果较小,说明加权过程中,权重衰减更快,可以看作只对临近几个数据平均。
指数加权平均公式的好处在于,它占用极少的内存,每次只存储上一次的变量,然后计算最新的数据并不断覆盖就可以了,而不需要为了拟合曲线读入所有的数据。
2.2 动量梯度下降法
基本思想为计算梯度的加权平均数,并利用该梯度更新权重。
比如要优化某个成本函数,梯度下降的过程中总是会慢慢摆动直到下降到最小值,这样的上下波动减慢了梯度下降的速度,并且不能使用更大的学习率,因为一旦学习率过大,结果就可能会超出函数的范围。
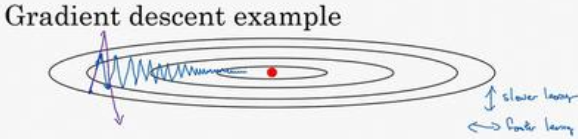
总结来说,我们希望在b方向学习慢一些,减少不必要的摆动,在W方向上加快学习,快速接近最小值。
因此,一个可以的解决方法是,使用动量梯度下降法。在每次迭代过程中,计算微分dW和db,并计算,同样计算,并将计算后的值重新赋值给dW和db,这样做有什么好处呢。
类似于上面的图,通过加权平均,将震荡往复的梯度值dW和db转换为连续变化的梯度值,使得在b方向上正负抵消,dW的摆动减小了,W方向上由于所有微分方向一致,因此W方向运动更快了。
可以理解为成本函数是一个碗状函数,梯度下降就是在碗的边缘滚下一个球,和项相当于在每一刻提供一个加速度,和相当于上一时刻的瞬时速度。因此速度会越滚越快,并且由于小于1,类似于表现出一些摩擦力,所以球不会无限加速下去。
因此动量梯度下降法过程如下:
这个过程中超参数有两个:动量和学习率
2.3 编程实现
def update_parameters_with_momentum(parameters, grads, v, beta, learning_rate):
    """
    使用动量更新参数

    参数:
    parameters -- 包含所有参数的python字典:
                    parameters['W' + str(l)] = Wl
                    parameters['b' + str(l)] = bl
    grads -- 包含所有参数的梯度的python字典:
                    grads['dW' + str(l)] = dWl
                    grads['db' + str(l)] = dbl
    v -- 包含当前速度的python字典:
                    v['dW' + str(l)] = ...
                    v['db' + str(l)] = ...
    beta -- 动量超参数,标量
    learning_rate -- 学习率,标量

    返回值:
    parameters -- 包含所有更新后的参数的python字典
    v -- 包含所有更新后的速度的python字典
    """

    L = len(parameters) // 2 # 神经网络的层数

    # 每个参数的Momentum更新
    for l in range(L):
        # 计算速度
        v['dW'+str(l+1)] = beta * v['dW'+str(l+1)] + (1 - beta) * grads['dW'+str(l+1)]
        v['db'+str(l+1)] = beta * v['db'+str(l+1)] + (1 - beta) * grads['db'+str(l+1)]
        # 更新参数
        parameters['W'+str(l+1)] -= learning_rate * v['dW'+str(l+1)]
        parameters['b'+str(l+1)] -= learning_rate * v['db'+str(l+1)]

    return parameters, v
三、RMSprop
RMSprop的全称是root mean square prop算法,也可以加速梯度下降。
数学表示如下:
参数更新过程如下:
原理如下:
我们希望学习速度快,并且要减缓摆动。于是有了和,我们希望较小,所以要除以一个较小的数,希望较大,所以要除以一个较大的数,这样就可以减缓b上的摆动。而且这些微分项里面,由于斜率在b的方向上要大于在W的方向,因此db大一些,dW小一些,除以一个较小的数也就是dW除以一个较小的数也就是db,因此有了上面的式子。
四、Adam
Adam优化算法全称为Adaptive Moment Estimation。是动量梯度下降法Momentum和RMSprop的结合。
具体步骤如下:
其中的常取,是为了避免出现除以0的情况,所以附加的微小值。
该算法结合了Momentum和RMSprop两种方法,被证明有效适用于不同的神经网络。
本算法涉及了多个超参数
- :学习率
- :Momentum相关的项,常用的缺省值为0.9
- :Adam相关的项,常用的缺省值为0.99
- :常用,该参数对算法没什么影响
编程实现
def update_parameters_with_adam(parameters, grads, v, s, t, learning_rate = 0.01,
                                beta1 = 0.9, beta2 = 0.999,  epsilon = 1e-8):
    """
    使用Adam进行参数更新

    参数:
    parameters -- 包含所有参数的python字典
                    parameters['W' + str(l)] = Wl
                    parameters['b' + str(l)] = bl
    grads -- 包含所有参数梯度的python字典
                    grads['dW' + str(l)] = dWl
                    grads['db' + str(l)] = dbl
    v -- Adam变量, 梯度一次项的移动的平均值, python字典
    s -- Adam变量, 梯度平方项的移动的平均值, python字典
    learning_rate -- 学习率,标量
    beta1 -- 第一种动量优化Momentum的指数衰减超参数
    beta2 -- 第二种动量优化RMSprop的指数衰减超参数
    epsilon -- 放置Adam参数更新过程中可能出现的0除现象

    返回值:
    parameters -- 包含所有更新后参数的字典
    v -- Adam变量, 梯度一次项的移动的平均值, python字典
    s -- Adam变量, 梯度平方项的移动的平均值, python字典
    """

    L = len(parameters) // 2                 # 神经网络的层数
    v_corrected = {}                         # 初始化第一种动量优化,字典
    s_corrected = {}                         # 初始化第二种动量优化,字典

    # 使用Adam方法更新所有参数
    for l in range(L):
        # 移动梯度的平均值. 输入: "v, grads, beta1". 输出: "v".
        v['dW'+str(l+1)] = beta1 * v['dW'+str(l+1)] + (1 - beta1) * grads['dW'+str(l+1)]
        v['db'+str(l+1)] = beta1 * v['db'+str(l+1)] + (1 - beta1) * grads['db'+str(l+1)]

        # 计算第一种动量优化的偏差矫正项. 输入: "v, beta1, t". 输出: "v_corrected".
        v_corrected['dW'+str(l+1)] = v['dW'+str(l+1)] / (1 - beta1 ** t)
        v_corrected['db'+str(l+1)] = v['db'+str(l+1)] / (1 - beta1 ** t)

        # 移动平方梯度的平均值. 输入: "s, grads, beta2". 输出: "s".
        s['dW'+str(l+1)] = beta2 * s['dW'+str(l+1)] + (1 - beta2) * (grads['dW'+str(l+1)] ** 2)
        s['db'+str(l+1)] = beta2 * s['db'+str(l+1)] + (1 - beta2) * (grads['db'+str(l+1)] ** 2)

        # 计算第二种动量优化的偏差矫正项. 输入: "s, beta2, t". 输出: "s_corrected".
        s_corrected['dW'+str(l+1)] = s['dW'+str(l+1)] / (1 - beta2 ** t)
        s_corrected['db'+str(l+1)] = s['db'+str(l+1)] / (1 - beta2 ** t)

        # 更新参数. 输入: "parameters, learning_rate, v_corrected, s_corrected, epsilon". 输出: "parameters".
        parameters['W' + str(l + 1)] -= learning_rate * v_corrected['dW' + str(l + 1)] / (np.sqrt(s_corrected['dW'+str(l+1)]) + epsilon)
        parameters['b' + str(l + 1)] -= learning_rate * v_corrected['db' + str(l + 1)] / (np.sqrt(s_corrected['db'+str(l+1)]) + epsilon)

    return parameters, v, s
五、学习率衰减
由于在梯度下降过程中,会围绕最小值往复震荡,但是不会精确的收敛,为了保证算法的效率。可以在初期设置较大的学习率,这样学习相对较快,梯度下降速度较快。接近最小值附近时,减小学习率,也就是减小步伐,逐渐逼近最小值。
因此可以这样操作,每一次遍历所有数据集,都让学习率减小一些。
(1)最常用的衰减公式
其中decay_rate为衰减率,epoch_num为迭代次数。随着epoch_num的增大,学习率会逐渐减小。
(2)指数衰减
(3)反比衰减
评论