【论文复现】MimicPlay从人类演示中学习机器人技能
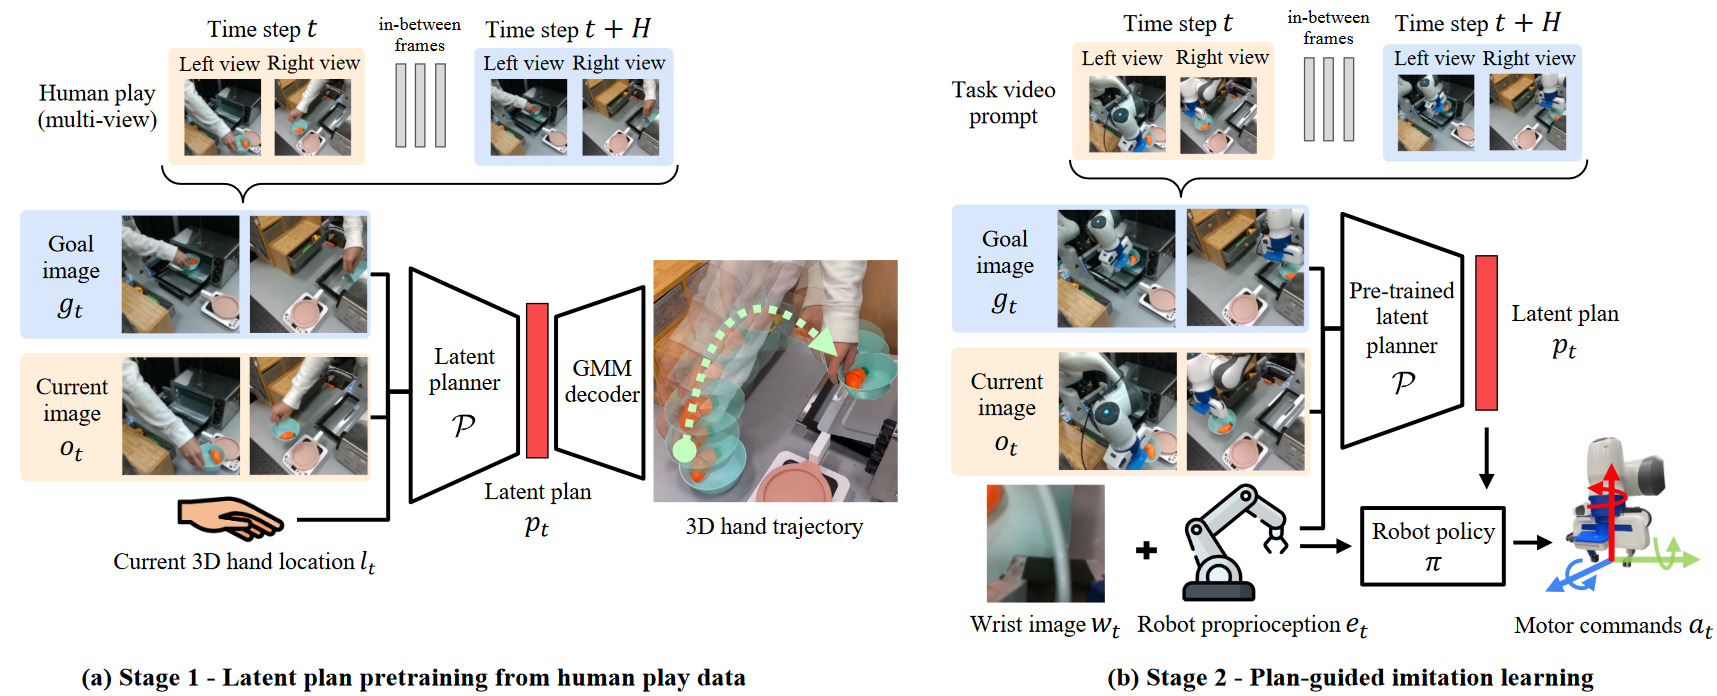
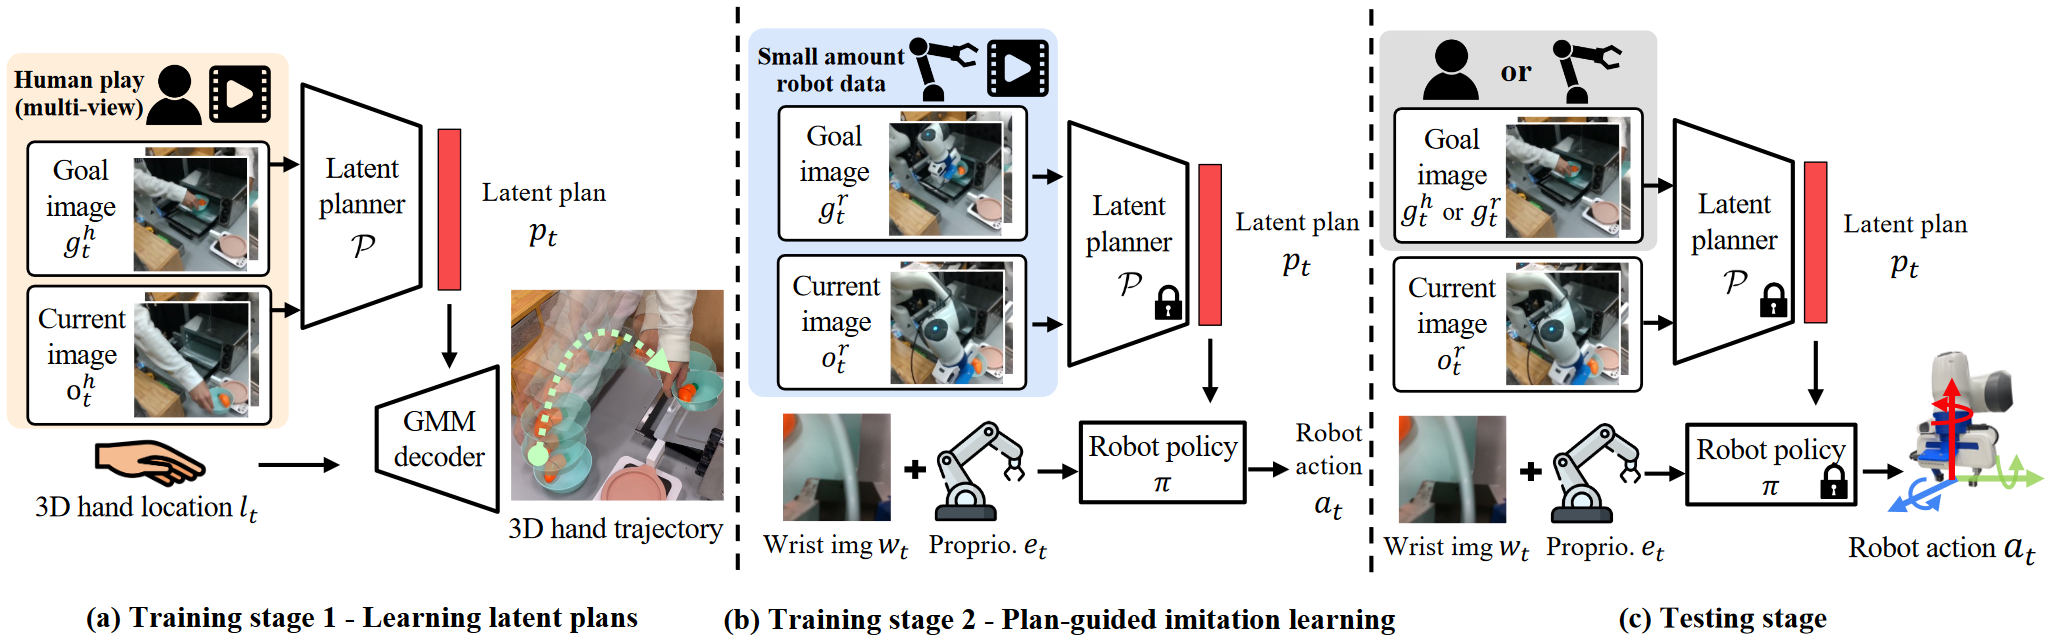
斯坦福大学李飞飞团队的通过观看人类动作进行长期模仿学习方法。
21 篇
斯坦福大学李飞飞团队的通过观看人类动作进行长期模仿学习方法。
Instant-NGP全称Instant Neural Graphics Primitives,它通过多分辨率哈希编码,解决了NeRF对全连接神经网络进行参数化时的效率问题,大大提升了网络的训练速度,使三维重建速度可以从几小时缩短到几秒钟。
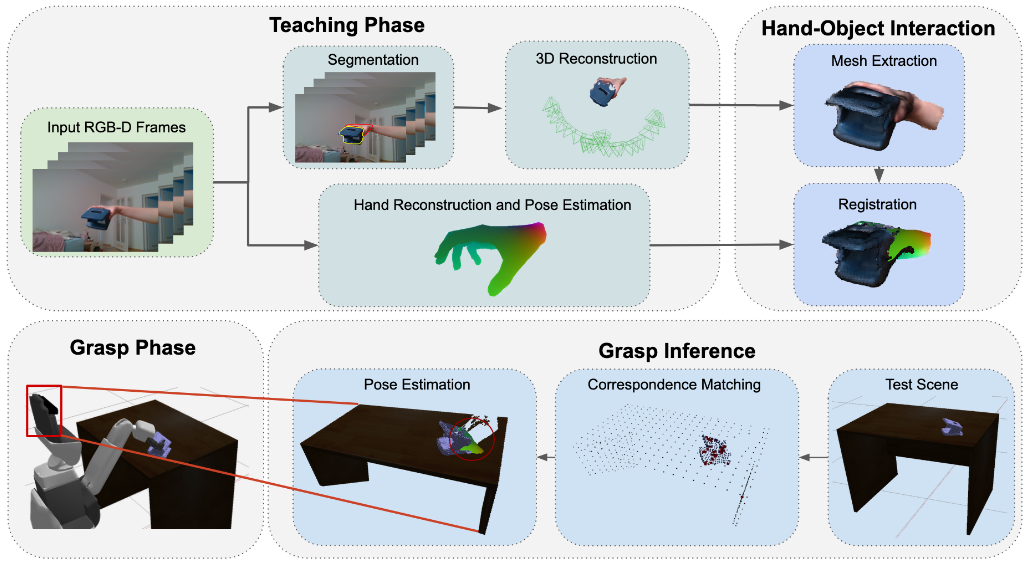
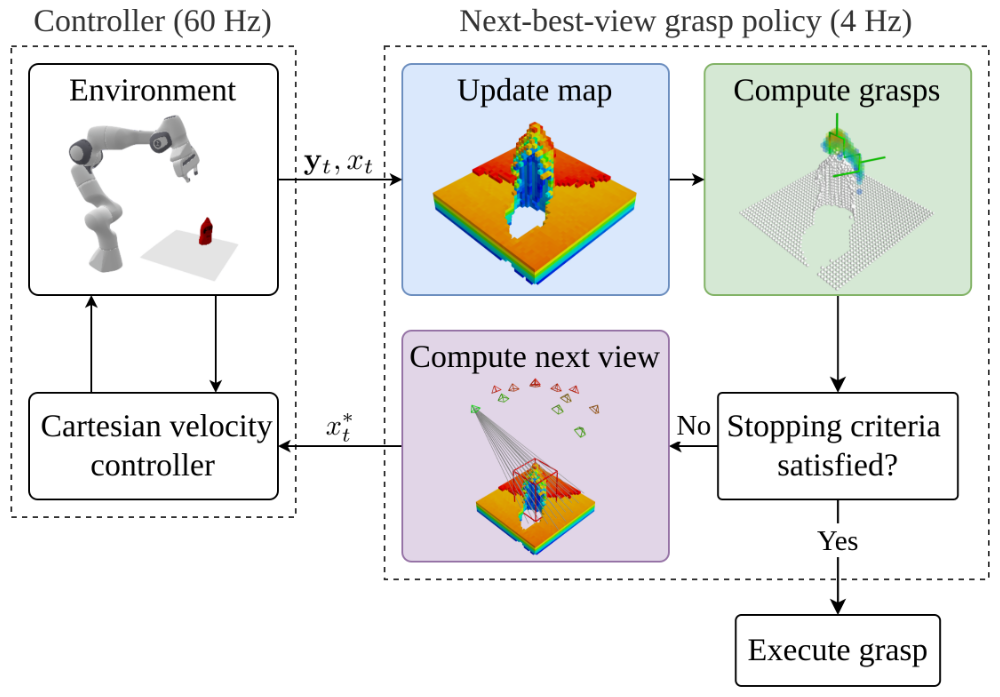
从人类抓取物体的视频中学习机器人的动作生成与规划方法,相关的研究的调研。
从人类抓取物体的视频中学习机器人抓取的相关工作调研。
复现上交提出的RGB Matters算法。
调研近三年顶会顶刊上的抓取姿态估计的论文
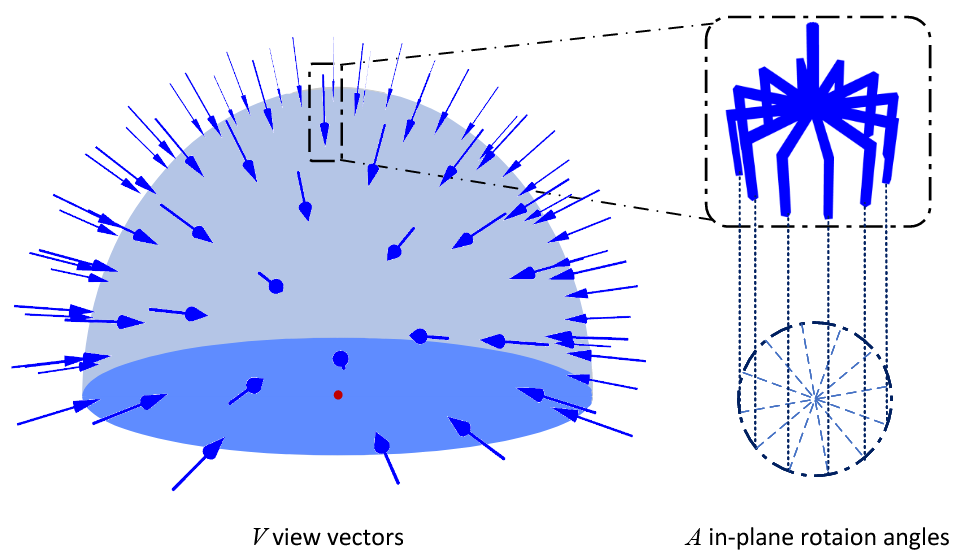
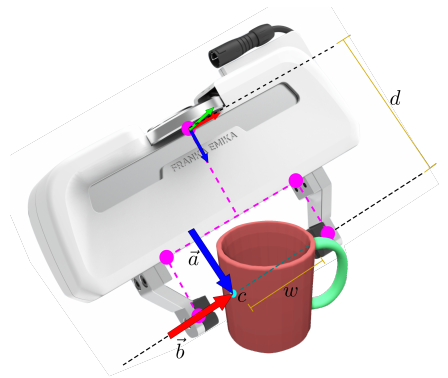
复现NVIDIA提出的抓取估计算法Contact GraspNet
算法复现
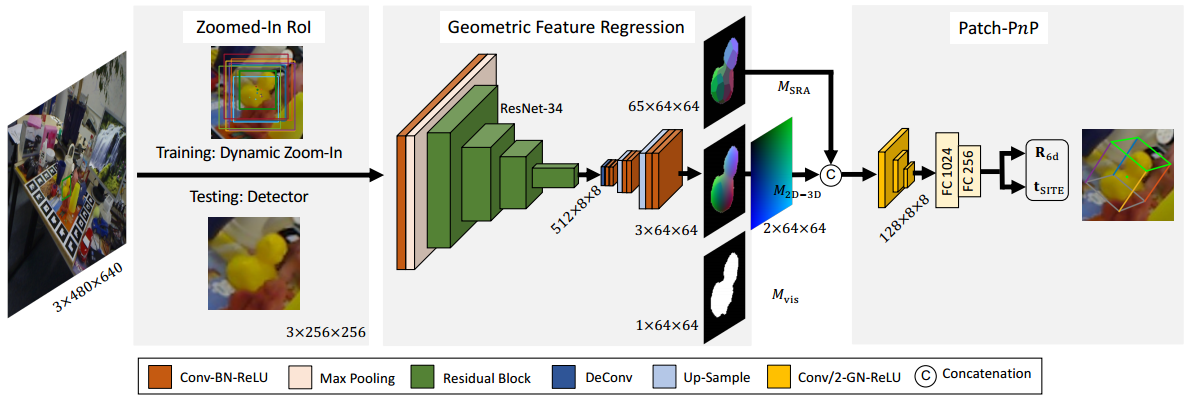
检索阅读近三年ECCV6D位姿估计相关论文并进行记录
检索阅读近三年CVPR6D位姿估计相关论文并进行记录
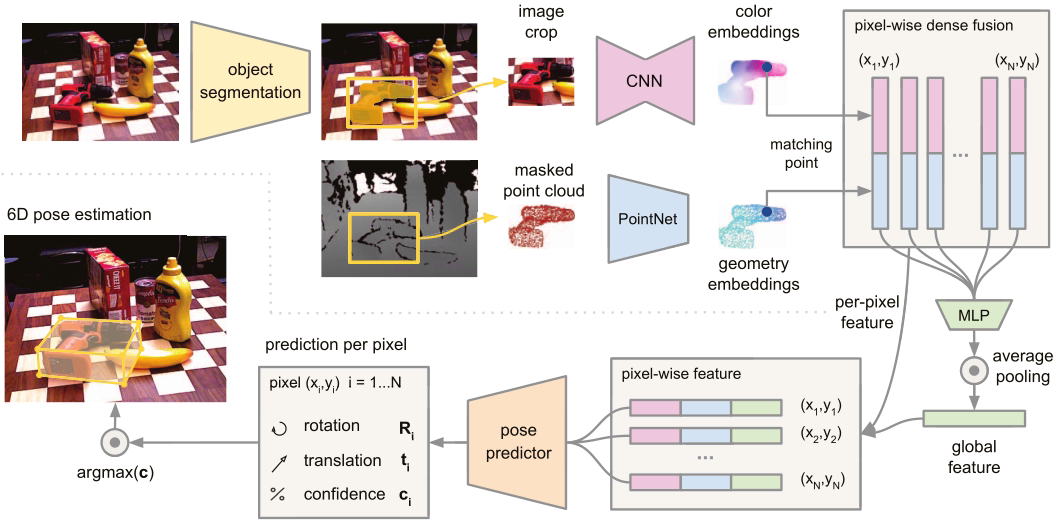
检索了DenseFusion的被引论文,但是因为太多都没有开源代码,看了两篇就转向只关注顶会论文了。
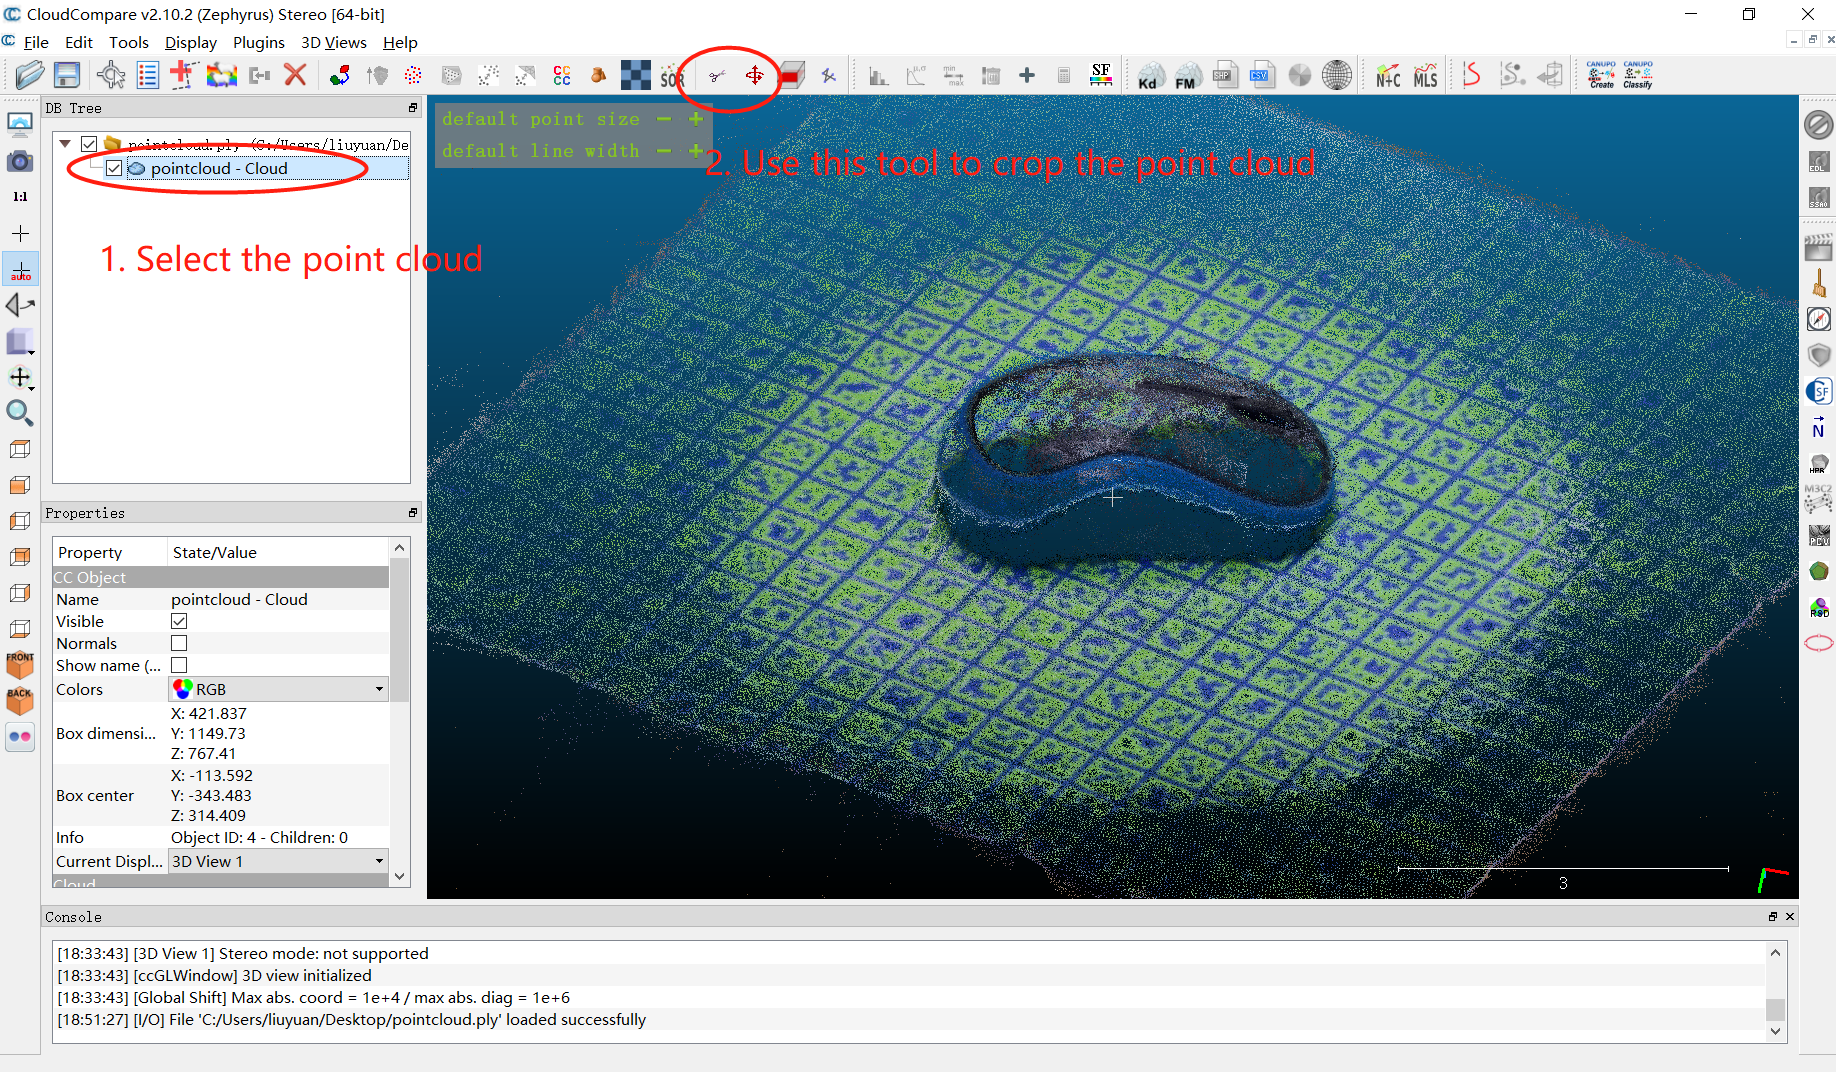
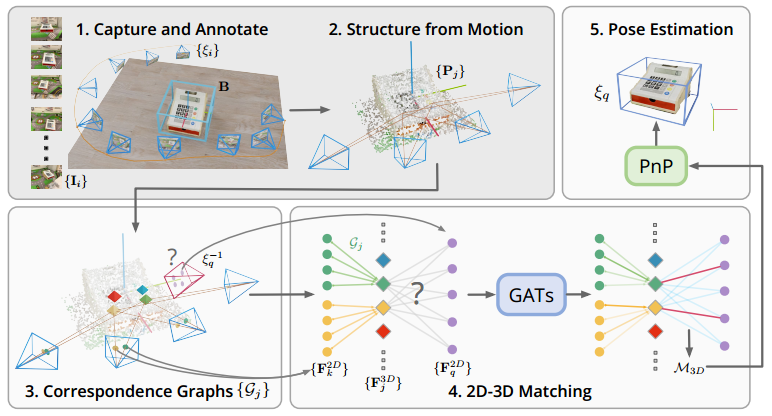
目前正在学习6D位姿估计算法,该领域最常用的数据集就是LineMod数据集,但是只在数据集上测试还是不够,想要实际应用还需要搭建自己的数据集。
FFB6D相当于在特征提取阶段就将RGB和点云信息进行了融合,然后进行实例分割和关键点检测。
本文提出了一种异形架构,对两个数据源(RGB和深度图)进行分别处理,并用一种新型的dense fusion network提取像素级稠密特征,从中估计姿态。
尝试测试PVNet,中途放弃。
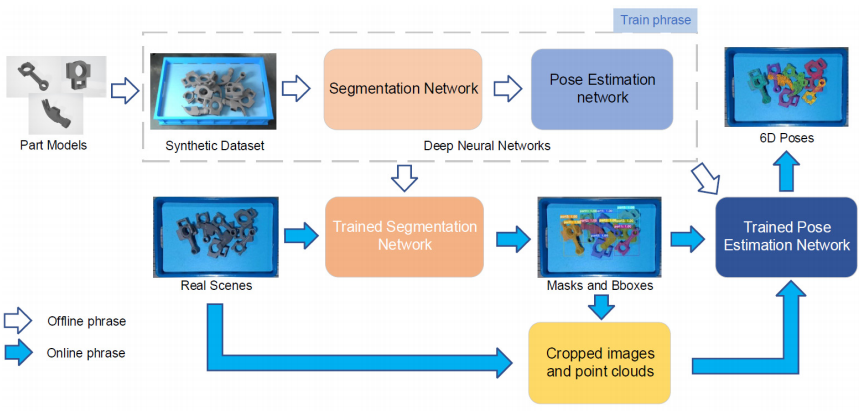
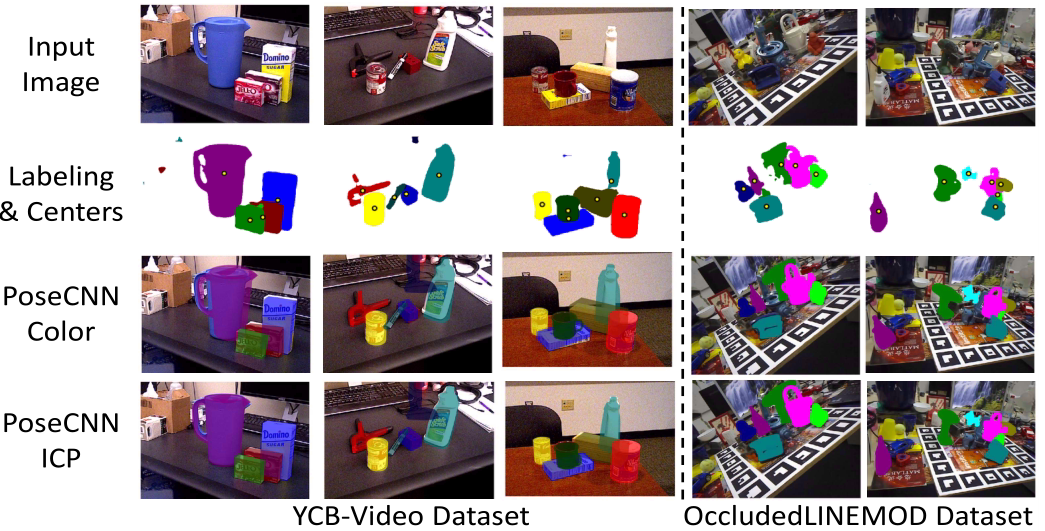
解决物体之间的遮挡和聚集增加的6D位姿估计的难度,通过主干网络加ICP点配对的方式实现位姿估计。
LineMod算法是Hinterstoisser等人在2011年提出的,通过采用模板匹配的方法,解决了杂乱场景下少纹理三维物体的实时监测与6D位姿估计定位问题。
COLMAP是一种通用的运动结构(SfM)和多视图立体(MVS)工具,具有图形和命令行界面。OpenMVS是目前的三维重建的框架中,复原效果较好的,而且提供自动化的脚本。
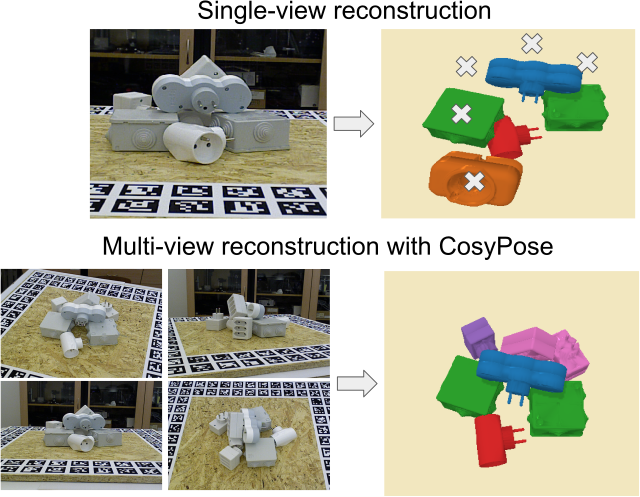
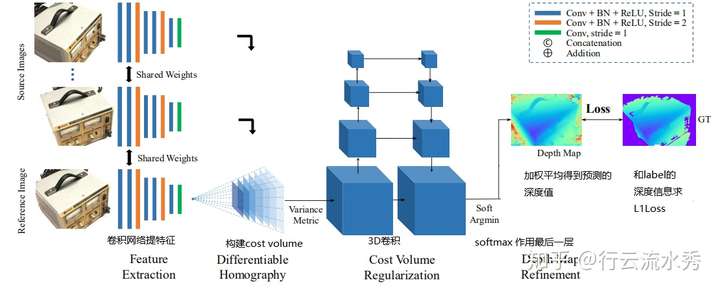
三维重建是用相机拍摄真实世界的物体、场景,通过计算机视觉技术进行处理,从而得到物体的三维模型。主要涉及技术包括:多视图立体几何、深度图估计、点云处理、网格重建和优化、纹理贴图、马尔可夫随机场、图像分割等。
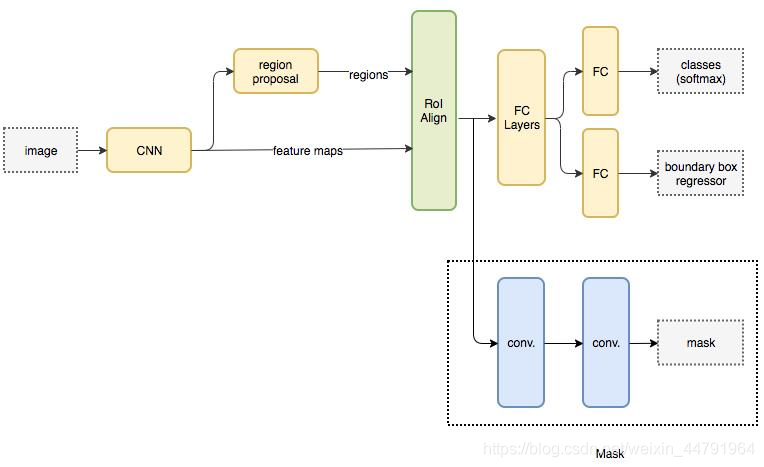
Mask R-CNN是He Kaiming大神2017年的力作,其在进行目标检测的同时进行实例分割,取得了出色的效果。