目录
- 一、贝叶斯定理
- 1.1 条件概率
- 1.2 贝叶斯定理
- 1.3 朴素贝叶斯
- 二、后验概率最大化准则
- 三、极大似然估计
一、贝叶斯定理
1.1 条件概率
条件概率属于概率论的内容,指的是已知在情况A的条件下,求发生事件B的概率,即P(B|A),计算方法如下。
P(B∣A)=P(A)P(AB)
1.2 贝叶斯定理
相对于条件概率,贝叶斯定理是其逆过程。已知发生事件B,求事件发生的情况A的概率,即P(A|B),计算方法如下,其中分母是全概率公式。
P(A∣B)=P(B)P(AB)=P(B∣A)⋅P(A)+P(B∣A^)⋅P(A^)P(A∣B)⋅P(B)
同理推广到分类问题,已知存在K类c1,c2…ck,给定一个新的实例x=(x(1),x(2)…x(n)),求该实例点归属于ci类的可能。
P(Y=ci∣X=x)=P(X=x)P(X=x∣Y=ci)⋅P(Y=ci)=∑i=1KP(X=x∣Y=ci)⋅P(Y=ci)P(X=x∣Y=ci)⋅P(Y=ci)
1.3 朴素贝叶斯
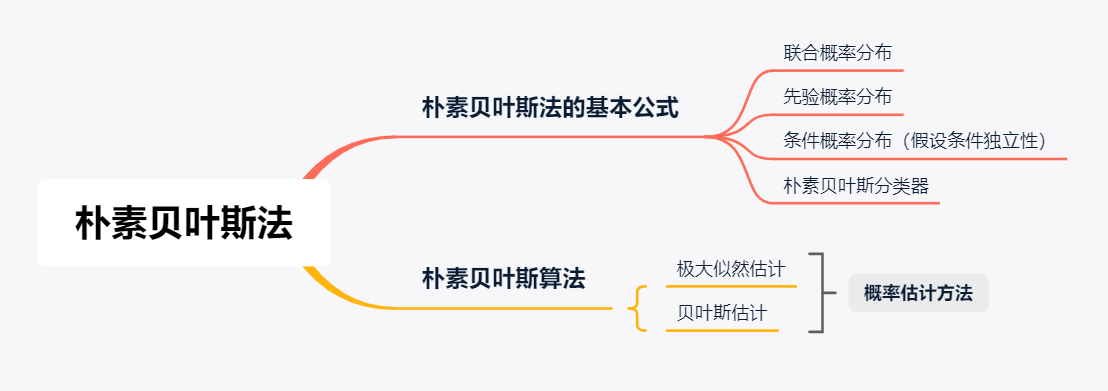
朴素贝叶斯相较于贝叶斯,多了实例特征之间相互独立这个条件,这样更便于计算
即P(X=x∣Y=ci)=∏j=1nP(X(j)=x(j)∣Y=ci)
因此
P(Y=ci∣X=x)=∑ciKP(Y=ci)∏j=1nP(X(j)=x(j)∣Y=ci)P(X=x∣Y=ci)⋅P(Y=ci)
P(Y=ci∣X=x)=∑ciKP(Y=ci)∏j=1nP(X(j)=x(j)∣Y=ci)P(Y=ci)⋅∏j=1nP(X(j)=x(j)∣Y=ci)
可以看出x属于任何分类ci的概率,其分母都是一样的,因此实际计算时只需要比较分子即可,即
argmaxP(Y=ci)⋅∏j=1nP(X(j)=x(j)∣Y=ci)
通过训练数据集,我们可以得到联合概率分布。
二、后验概率最大化准则
三、极大似然估计
评论